
Om csv file te openen die op u pc staat
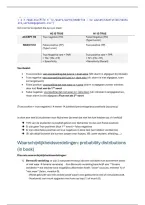
H2 IS TRUE H1 IS TRUE
ACCEPT H2 True negative (TN) False Negative (FN)
(Type II error)
REJECT H2 False positive (FP) True positive (TP)
(Type I error)
True Negative rate = TNR True positive rate = TPR
= TN / (TN + FP) = TP / (FN + TP)
= Specificity =Sensitivity (Recall)
Voorbeeld:
• True possitive: een voorspelling dat juist is + doet actie (VB: alarm is afgegaan bij inbraak)
• True negative: een voorspelling dat juist is + doet niks (vb: alarm is niet afgegaan, toen
kat langskwam)
• False positive: voorspelling dat niet waar is + actie (alarm is afgegaan zonder inbreker,
door kat) Fout van de 1ste soort
• False negative: voorspelling dat niet waar is + niks doen (vb: inbreker is langsgekomen,
maar alarm is niet afgegaan) Fout van de 2de soort
(True positive + true negative) / # testen → juistheid percentage/accuraatheid (accuracy)
Je doet een test bij studenten voor Alzheimer (je weet dat niet het kan hebben op z’n leeftijd)
➔ 15% van de studenten is positief getest voor Alzheimer (is dus een False positive)
➔ Er zijn geen True positives (fout 1ste soort) + false negatives
➔ Er zijn enkel false positives en true negatives in deze test (we hebben voorkennis)
➔ (Er zijn altijd factoren die kunnen zorgen voor foutjes, VB: zatte student, afleiding,…)
Waarschijnlijkheidsverdelingen: probability distributions
(in boek)
Discrete waarschijnlijkheidsverdelingen:
1) Bernoulli verdeling: er zijn 2 statussen/niveaus die een variabele kan aannemen (waar
of niet waar → binaire variabele) - Een Bernoulli-verdeling beschrijft een **binaire
variabele** die slechts twee mogelijke uitkomsten heeft: "waar" (succes, meestal 1) of
"niet waar" (falen, meestal 0).
- Wordt gebruikt voor één enkele proef waarin een gebeurtenis wel of niet plaatsvindt.
- Voorbeeld: een munt opgooien met kans op kop (1) of munt (0).
, 2) Binominale verdeling: Als we meermaals een Bernoulli experiment gaan meten (n keer
uitgevoerd), dan kan het zijn dat het aantal successen dat je waarneemt = aan getal r <=1
➔ Wat is de kans dat het aantal successen = een getal (r), als je weet dat de sequentie
experimenten die je uitvoert, Bernoulli experimenten met een vaste
waarschijnlijkheid op succes zijn.
➔ Je gebruikt de Binominale verdeling voor een nauwkeurig antwoord (geen simulatie)
➔ Voorbeeld: de kans om precies 3 koppen te krijgen als je 10 keer een eerlijke munt
opgooit.
➔ Kan ook in R (programmeertaal) → gebruikt logica die je gebruikt bij de links
➔ Geïntegreerde software van handboek kan ook gebruikt worden
o 45 geboortes per dag → 45 number of Bernoulli trials
o 27 = 60% * 45 (die 60% reken je uit) (vragen in les)
3) Multinomiale verdeling: uitbreiding van de binominale verdeling (geen 2 uitkomsten,
maar k aantal uitkomsten)
1. Wat is de bedoeling van die verdeling? Wordt gebruikt om de multinomail naïve
Bayes classifier te definiëren. (hoofdstuk 8)
Continue waarschijnlijkheidsverdeling:
1) Uniforme verdeling:
1. dichtheidsfunctie begint bij ondergrens en eindigt bij bovengrens en is
horizontaal
a. Die zegt dat alle waarden tussen a en b even waarschijnlijk zijn
2. Distribution function (= verdeling) (= cumulatieve dichtheidsfunctie)
a. Is een stijgende lijn
3. Skewness: de skewness van een uniforme verdeling = 0
→ de verdeling is symmetrisch (Je kunt verticale rechte tekenen zodat de linker
en rechter kant elkaars spiegelbeeld zijn) → symmetrische dichtheidsfunctie
4. Kurtosis: (hoe dik zijn de staarten van de dichtheidsfunctie) (vaak interessanter
dan het midden van de verdeling)
a. hoe groter de kurtosis, hoe groter de uiteinde links en rechts van de
verdeling → hoe groter de kans dat je extreme waarden hebt
b. Uniforme verdeling = 9/5
1. Grotere kurtosis van 9/5 → extreme waarden komen frequenter
voor (waarschijnlijker)
,2) Normaal verdeling:
1. Location = gemiddelde
2. Scale = standaarddeviatie
punt is op de 5, afstand buigpunt = 2
3. Expected value = verwachte waarde
a. Als een fenomeen normaal verdeelt is, dan kan ik een normaalverdeling
schatten (nu (µ) en sigma (E(X)) kan ik schatten, van data dat ik heb)
Als ik predictie wil, gebruik ik de µ als predictie
4. Variantie is de maatstaf voor de onzekerheid (hoe zeker/onzeker ben je over de
predictie die je maakt met µ)
5. Coefficient of skewness: skewness van normaalverdeling = 0
6. Coefficient of kurtosis: kurtosis = 3 (dikte van de staarte van normaal verdeling
is altijd gelijk)
7. Parameterschatting: als ik datareeks krijg, dan kan ik met de tools berekenen
welke de meest waarschijnlijke µ en sigma zijn
8. Aantal properties (eigenschappen): effe lezen
9. Related distributions: verbanden met andere vergelijkingen
a. = chi kwadraatverdeling
b. 4de is verband dat we gaan gebruiken
3) Gaussian naive bayes classifier: niet categorische data (continue verdeling)
1. Example: (type=heb je diabetisch of niet, binaire)
Na de ~ komen de verklarende factoren (npreg = number of pregnanties) (glu =
glucose) (bp = blup?)
2 classes: 2 statussen (diabetisch ja of nee)
Samples: aantal observaties in de dataset (# patiënten) (hangt af van auteur)
, Features: 3 verklarende factoren (exogene variabele) (zie foto)
Gaussian: 3 normaalverdelingen (we veronderstellen dat de 3 factoren zijn
normaal verdeelt)
Prior probabilities: kans op diabetisch door een specialist gezegd, of database
prior (in database kijken)
Verwachte waarde rode curve is lager dan bij de groene (hoe groter het verschil
tussen die 2, hoe verder die 2 normaalverdelingen van elkaar gelegen zijn, hoe
beter de voorspellende waarde is van de variabele (npreg) die we bekijken)
Je moet kijken naar de gemiddelde (waar toppen van die curvesliggen, 5 en 3 in
foto)
Met training set ga je voorspelling maken van de dataset
→cunfusion matrix geeft aan welke goed en welke slecht voorspelt werden
Welke variabele heb ik nodig? Aantal factoren + shuffle heeft groot effect
Examen kans groot dat je zelf zo een model moet maken
4) Chi verdeling: niet gebruiken in onze oefeningen (enkel gebruiken voor de chi kwadraat)
Bijna altijd die met 1 parameter
Chi kwadraat verdeling = som van kwadraten van normaalverdelingen
geen symmetrische verdeling, maar rechts scheve
verdeling (unimodaal = heeft maar 1 buld) (gaat niet onder 0, niet complex)
df = 10 (vrijheidsgraden) (= aantal termen/normaalverdelingen in de som die ik gebruikt
heb) (hoe hoger de df, hoe symmetrischer)
verwachte waarde = n = aantal termen (aantal vrijheidsgraden)
Skewness is afhankelijk van die n
Kurtosis (dikte) is ook afhankelijk van die n


