
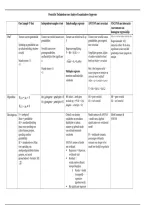
Overzicht Technieken voor Analyse Kwantitatieve Gegevens
One Sample T-Test Independent-samples t-test Enkelvoudige regressie ANCOVA met covariaat ANCOVA met interactie
voor toetsen van
homogene regressielijn
Wat? Toetsen van één gemiddelde Toetsen van verschil tussen twee Toetsen van invloed van X op Toetsen voor verschil tussen
gemiddelden Y gemiddelden, gecorrigeerd Regressiemodel: b12,
Spreiding in gemiddelde aan door covariaat interactie-effect als deze
op schaalverdeling, relatieve Verschil tussen twee Regressievergelijking: significant is dan verschilt
verschil groepsgemiddelden, Ŷ = B0 + B1X1 + e Vergelijken groepen, kijken groeitempo tussen jongens en
onafhankelijk of het significant of andere variabel invloed meisjes
Waarde tussen -3/ is heeft op relatie = covariaat
+3
Waarde tussen -3/ Wat is het lengteverschil
+3 Multipele regressie: tussen jongens en meisjes na
meerdere onafhankelijke correctie voor leeftijd?
variabelen
Ŷ = B0 + B1X1 + B1X2
Hypothese H0: μjongens−μmeisjes=0 H0: sekse/... heeft geen H0 = geen verschil H0 = geen verschil
H1: μjongens−μmeisjes ≠ 0 invloed op y B1 = 0 (u H1 = wel verschil H1 = wel verschil
jongens – u meisjes = 0)
Descriptives N = steekproef Gebruik van dummy Model summary & ANOVA Model summary &
Mean = gemiddelde variabelen om resultaten – model toets, algehele ANOVA
SD = standaardafwijking duidelijker te maken; significantie voor verklarend
(maat voor spreiding van wanneer je gebruik maakt model
cijfers binnen groepen, van ordinale/nominale
spreiding rondom variabelen R² = verklaarde variantie,
gemiddelde) percentage verklaarde
SE = standaarderror (Maat ANOVA: toetsen of model variantie van lengte in het
voor spreiding van iets verklaard model met leeftijd en geslacht
steekproefgemiddelde binnen Regression = Regressie,
groepen, wat wordt verklaarde stuk
geconcludeerd - Formule: SD/ Residual =
√n ) residu,onderverklaard,
voorspellingsfout
o Residu = model
(voorspeld) –
regressive
(geobserveerd)
Bij significante regressie
, Overzicht Technieken voor Analyse Kwantitatieve Gegevens
= model verklaard
Output T-waarde = Mean Difference / T = mean difference / Regressie-coëfficiënten: Coëfficiënts: vrijwel zelfde Coëfficiënts: interactie-effect
SE Difference SEverschil b0 = intercept als bij regressie, één toegevoegd
Mean difference = Yjongens – b1 = regressie- bepalende factor extra
Ymeisjes coëfficiënt, wat je wilt b2 = … = geschatte
Vrijheidsgraden (df) = N – 1 weten verschil in lengte tussen
jongens en meisjes
gecorrigeerd door
leeftijd
T = mean difference / SE
difference B1 / SE
R² = verklaarde variantie
steekproef (effectgrootte) =
bepaalt goodness of fit
= SSm/SSt
ρ² = toetst significantie R²
dus gehele model
b (unstandardized) =
regressievergelijking
opstellen
β = vergelijking predictoren
Assumpties Homogene variantie: - Aselect gekozen - Onafhankelijke waarnemingen
spreiding/variantie tussen bij participanten - Meetniveau variabelen
groepen is gelijk Levene’s - Specificatie - Geen uitschieters
- Homoscedasticiteit
test (geschonden wnr verklaringsmodel
- Normaal verdeelde residuen
significant) - Meetniveau variabelen - Meetniveau covariaat
- Lineaire relatie variabelen - Lineaire relatie covariaat en Y
- Geen uitschieters - Homogene regressie (geen
- Homoscedasticiteit: interactie)
spreiding residuen - Covariaat onafhankelijke
- Normaal verdeelde residuen experimentele effect
- Geen Multicollineariteit:
relaties onafhankelijke
variabelen
General lineair model
Data = Model + Error


