
Week 1 college 1
Model: parameters en variabelen
Variabelen: hetgeen wat je meet (zoals vermoeidheid). Dit varieert
tussen de mensen in de steekproef)
Parameters: de constante relaties tussen variabelen die je probeert te
omvatten binnen je model (bij een regressie is dit bijvoorbeeld de slope en
intercept)
Error berekenen
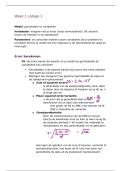
Fit: de mate waarin de waarde uit je model (je gemiddelde) de
variabiliteit kan verklaren
Gemiddelde is de waarde waarbij de scores het minst afwijken
(het heeft de minste error)
Metingen die aangeven hoe goed het gemiddelde de data uit
de steekproef representeert:
o Sum of squared errors
Is afhankelijk van de steekproefgrootte. Door deze
te delen door de degrees of freedom los je dit op >
je krijgt dan de:
o Mean squared error/variantie
= de error die je gemiddeld hebt in het
beschrijven van je data voor elke persoon
Hoe groter de SS en MSE, hoe slechter de fit
MSE is hetzelfde als variantie
o Standaarddeviatie
Door de vierkantswortel van de MSE te nemen,
haal je de kwadraten eruit en kom je weer terug bij
de originele eenheid > dit maakt het makkelijk te
interpreteren en dus aantrekkelijk om te gebruiken
Hoe lager de getallen van de sum of squares, variantie of
standaarddeviatie, hoe beter de fit (dus hoe beter het
gemiddelde de data uit de steekproef representeert)
,Het ware gemiddelde van een populatie weet je niet, maar je doet hier een
schatting over op basis van jouw steekproef
Het gemiddelde verschil tussen de het gemeten gemiddelde van elk
van de willekeurig getrokken steekproeven uit de populatie is de
variabiliteit van de steekproefverdeling
Steekproefverdeling: hoe de gemeten parameter verschilt over
de herhaalde steekproeftrekkingen
Centrale limietstelling: de gemiddelden van steekproeven zullen
altijd normaal verdeeld zijn als je steekproeven van voldoende
omvang (N=30) neemt, zelfs als de populatie niet normaal verdeeld
is
Gemiddelde: standaarddeviatie:
Door de standaarddeviatie van de steekproef te delen door de
wortel van de steekproefgrootte krijg je hoeveel het
steekproefgemiddelde afwijkt van het populatiegemiddelde
Hoe groter N, hoe kleiner SE (de error) > grotere
steekproeven geven een meer betrouwbare schatting
van het populatiegemiddelde
Betrouwbaarheidsintervallen:
95% CI: voor 95% van alle mogelijke steekproeven ligt het
populatiegemiddelde binnen het bereik
Je gebruikt een t-waarde (deze is afhankelijk van de
steekproefgrootte) en de standaarderror en zoek je op in de
tabel op basis van de betrouwbaarheid die je wil (in tabel: two-
tailed voor 0.05 bij CI = 95%)
df = N – 1
Laagste gebied van CI =
Hoogste gebied van CI =
, Bij een steekproefgrootte van meer dan 30 gebruik je geen t-waarde,
maar een Z-waarde. Bij een 95% CI is dit 1.96
Je kunt x berekenen door de formule om te draaien
Het laagste gebied van de betrouwbaarheidsinterval bij 95% is dan:
Het hoogste gebied is dan:
Je kunt je hypothese testen door het berekenen van de p-waarde, of door
te kijken of het getal 0 binnen het betrouwbaarheidsinterval ligt (de
nulhypothese wordt dan niet verworpen)
Als je een kleine steekproef hebt, gebruik je voor een
betrouwbaarheidsinterval in plaats van Z-waardes t-waardes:
t-waarde berekenen:
Als de t-waarde groter is dan 2, valt het buiten het bereik van
normaal in de verdeling en is het dus significant
Valkuilen:
Een significant effect betekent niet per se dat het een belangrijk
effect is (hiervoor heb je meestal een effectgrootte nodig)
Type I (zeggen dat er een effect is die er niet is) en type II errors
(zeggen dat er geen effect is terwijl die er wel is)
Een niet-significant effect betekent nog niet dat H0 waar is
P-waardes variëren veel meer van elkaar over verschillende
steekproeven dan betrouwbaarheidsintervallen
Test statistic: ratio effect en erro
, Hypothese testen:
De nulhypothese zegt dat er geen effect bestaat
De alternatieve hypothese zegt dat er wel een effect bestaat
Je berekent een toets statistiek die de alternatieve hypothese
representeert en berekent de kans dat je deze waarde zou
vinden als de nulhypothese waar zou zijn
Als deze kans kleiner dan 0.05 is, verwerp je de
nulhypothese en ga je ervan uit dat er een effect is
Twee soorten error:
Type I: denken dat er een effect is, terwijl deze er in werkelijkheid
niet is
Type II: denken dat er geen effect is, terwijl deze er in werkelijkheid
wel is
Power = de kans dat je een effect vindt als deze er is
De significantie van een test is gelinkt aan de steekproefgrootte: kleine
verschillen kunnen significant zijn in een grote steekproef, en grote
effecten kunnen niet-significant zijn in een kleine steekproef
Researcher degrees of freedom:
Er zijn veel verschillende manieren waarop een onderzoeker de p-waarde
kan beïnvloeden, zoals:
Selectief excluderen van data
Verschillende modellen gebruiken, maar alleen degene met de beste
resultaten rapporteren
De dataverzameling op een ander punt stoppen dan van tevoren is
vastgesteld
Alleen controlevariabelen toevoegen die de p-waarde positief
beïnvloeden
P-hacking: selectief rapporteren van significante p-waardes
HARKing: hypotheses opstellen nadat de resultaten bekend zijn



